2.常用库(共 15 个)
大约 26 分钟约 7886 字
2.常用库(共 15 个)
1,os 模块
import os
# 判断文件是否存在
os.path.exists()  #  判断文件或者文件夹是否存在,返回布尔值

os.path.join()    # 路径拼接
os.path.join(path1,path2,path3)

os.makedirs()     # 创建文件夹


os.getcwd()  # 获取当前工作目录,即当前python脚本工作的目录路径
os.chdir("dirname")  # 改变当前脚本工作目录;相当于shell下cd
os.curdir  # 返回当前目录: ('.')
os.pardir  # 获取当前目录的父目录字符串名:('..')
os.makedirs('dirname1/dirname2')    # 可生成多层递归目录
os.removedirs('dirname1')    # 若目录为空,则删除,并递归到上一级目录,如若也为空,则删除,依此类推
os.mkdir('dirname')    # 生成单级目录;相当于shell中mkdir dirname
os.rmdir('dirname')    # 删除单级空目录,若目录不为空则无法删除,报错;相当于shell中rmdir dirname
os.listdir('dirname')    # 列出指定目录下的所有文件和子目录,包括隐藏文件,并以列表方式打印
os.remove()  # 删除一个文件
os.rename("oldname","newname")  # 重命名文件/目录
os.stat('path/filename')  # 获取文件/目录信息
os.sep    # 输出操作系统特定的路径分隔符,win下为"\\",Linux下为"/"
os.linesep    # 输出当前平台使用的行终止符,win下为"\t\n",Linux下为"\n"
os.pathsep    # 输出用于分割文件路径的字符串 win下为;,Linux下为:
os.name    # 输出字符串指示当前使用平台。win->'nt'; Linux->'posix'
os.system("bash command")  # 运行shell命令,直接显示
os.environ  # 获取系统环境变量
os.path.abspath(path)  # 返回path规范化的绝对路径
os.path.split(path)  # 将path分割成目录和文件名二元组返回
os.path.dirname(path)  # 返回path的目录。其实就是os.path.split(path)的第一个元素
os.path.basename(path)  # 返回path最后的文件名。如何path以/或\结尾,那么就会返回空值。即os.path.split(path)的第二个元素

os.path.exists(path)  # 如果path存在,返回True;如果path不存在,返回False
os.path.isabs(path)  # 如果path是绝对路径,返回True
os.path.isfile(path)  # 如果path是一个存在的文件,返回True。否则返回False
os.path.isdir(path)  #如果path是一个存在的目录,则返回True。否则返回False
os.path.join(path1[, path2[, ...]])  # 将多个路径组合后返回,第一个绝对路径之前的参数将被忽略
os.path.getatime(path)  # 返回path所指向的文件或者目录的最后存取时间
os.path.getmtime(path)  # 返回path所指向的文件或者目录的最后修改时间
os.path.getsize(path) # 返回path的大小
2,json 模块
## JSON格式兼容的是所有语言通用的数据类型,不能支持单一数据类型

# JSON ---------字典
dic = json.loads(s)

# 字典-----------JSON
s = json.dumps(dic)

import json
## 有时保存下来的中文数据打开后发现变成ASCII码,这是需要将ensure_ascii参数设置成False
    data = {
        'name' : 'name',
        'age' : 20,
    }
    json_str = json.dumps(data,ensure_ascii=False)

# josn.dump
    data = {
        'name':'name',
        'age':20,
    }
    #讲python编码成json放在那个文件里
    filename = 'a.txt'
    with open (filename,'w') as f:
        json.dump(data ,f)

## json.load
    data  = {
        'name':'name',
        'age':20
    }
    filename = 'a.txt'
    with open (filename,'w') as f:
        json.dump(data,f)
    with open (filename) as f_:
        print(json.load(f_))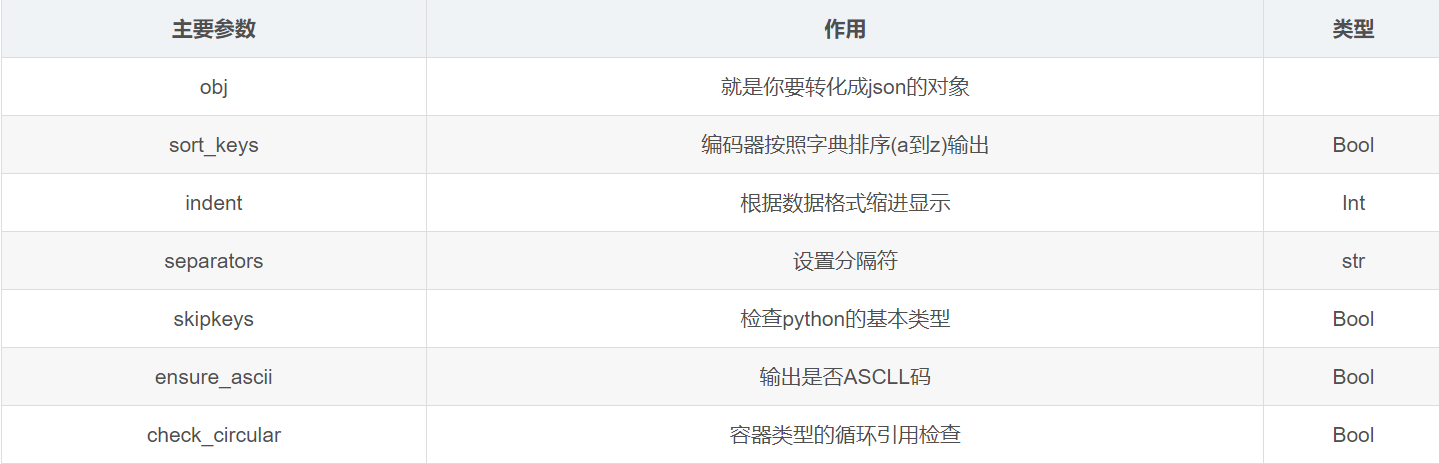
2.1 猴子补丁 S
### 在入扣文件处进行猴子补丁
import json
import ujson

def monkey_patch_json():
    json.__name__ = 'ujson'
    json.dumps = ujson.dumps
    json.loads = ujson.loads

monkey_patch_json()
3,random 模块
a = random.choice('abcdefghijklmn')  # 参数也可以是个列表

a = "abcdefghijklmnop1234567890"
b = random.sample(a,3)   # 随机取三个值,返回一个列表

num = random.randint(1,100)


1,random.random()   # 得到的是 0----1 之间的小数 -------------- 0.6400374661599008
2,random.randint(1,3) # 范围是  [1,3]  包头包尾
3,random.randrange(1,2) # 范围是 [1,3)  顾头不顾尾
4,random.chioce('abcdefghijklmn')  # 参数也可以是个列表
5,random.sample(['a','b','c','d'],3)  # 随机取三个值,返回一个列表

6,random.uniform(1,3)  # 得到 1-------3 之间的浮点数

item = [1,2,3,4,5,6,7,8,9]
7,random.shuffle(item) # 洗牌,打乱顺序  [4, 1, 2, 9, 7, 5, 6, 3, 8]
4,string 模块
string.ascii_letters  # 返回小写字母大写字母字符串
# 'abcdefghijklmnopqrstuvwxyzABCDEFGHIJKLMNOPQRSTUVWXYZ'

string.ascii_uppercase # 返回大写字母的字符串
# 'ABCDEFGHIJKLMNOPQRSTUVWXYZ'

string.ascii_lowercase # 返回小写字母的字符串
# 'abcdefghijklmnopqrstuvwxyz'

string.punctuation # 打印特殊字符
# '!"#$%&'()*+,-./:;<=>?@[\]^_`{|}~'

string.digits  # 打印数字
# '0123456789'
5,异常处理
5.1 错误类型
## 语法错误 SyntaxError
## 逻辑错误 NameError  IndexError  ZeroDivisionError ValueError


## 一种是语法上的错误SyntaxError,这种错误应该在程序运行前就修改正确
 if
  File "<stdin>", line 1
    if
     ^
SyntaxError: invalid syntax

# -------------------------------------------------------------------------------------------
# TypeError:数字类型无法与字符串类型相加
1+’2’

# ValueError:当字符串包含有非数字的值时,无法转成int类型
    num=input(">>: ") #输入hello
    int(num)

# NameError:引用了一个不存在的名字x
  x

# IndexError:索引超出列表的限制
    l=['egon','aa']
    l[3]

# KeyError:引用了一个不存在的key
    dic={'name':'egon'}
    dic['age']

# AttributeError:引用的属性不存在
    class Foo:
        pass
    Foo.x

# ZeroDivisionError:除数不能为0
  1/0
5.1 逻辑错误两种处理方式
5.1.1 错误时可以预知的
age = input(">>:").strip()

if age.isdigit():  ## 可以用if 判断避免错误出现
    age = int(age)  ## age必须是数字,才能转换为int类型
    if age > 18:
        print("猜大了")
    else:
        print('猜小了')
5.1.2 错误时不可预知的
## 只要抛出异常同级别的代码不会往下运行

try:
    ##有可能抛出异常的子代码块

except 异常类型1 as e:
    pass
except 异常类型2 as e:
    pass

....
else:
    ## 如果被检测的子代码块没有异常发生则运行else
finally:
    ## 无论有没有异常发生都会运行此代码

## --------------------------------------------------------------------------------------------

## 用法一
try:
  print('11111111111')
  l = ['aaa','bbbb']
  l[3]  ## 抛出异常IndexError,该码块同级别的后续代码不会运行
  print('222222222222222')
  xxx
  print('3333333333333333333')
  dic = {'a':1}
  dic['a']
  print('end')
except IndexError as e:
  print('异常处理了')
  print(e)
except NameError as e:
  print('异常处理了')
  print(e)
  ## --------------------------------------------------------------------------------------
# 用法二

print('start')
try:
  print('11111111111')
  l = ['aaa','bbbb']
  l[3]  ## 抛出异常IndexError,该码块同级别的后续代码不会运行
  print('222222222222222')
  # xxx
  print('3333333333333333333')
  dic = {'a':1}
  dic['a']
  print('end')
except (IndexError,NameError) as e:
  print('异常处理了')
except KeyError as e:
  print('字典的key不存在',e)

    ## ------------------------------------------------------------------------------------------
## 用法三
## 万能异常

print('start')
try:
  print('11111111111')
  l = ['aaa','bbbb']
  l[3]  ## 抛出异常IndexError,该码块同级别的后续代码不会运行
  print('222222222222222')
  # xxx
  print('3333333333333333333')
  dic = {'a':1}
  dic['a']
  print('end')
except Exception as e:  ## 万能异常,都能匹配上
  print('万能异常')
## ----------------------------------------------------------------------------------------

## 方法四
##tyr 不能跟 else 连用

try:
  print('11111111111111')
  print('33333333333')
  print('2222222222222222222')
except Exception as e:
  print('所有异常都能匹配到')
else:
  print('==============>')

print('end...........')

## ------------------------------------------------------------------------------------------

## 方法五
## finally 可以单独与try配合使用

print('start')
try:
  print('11111111111')
  l = ['aaa','bbbb']
  l[3]  ## 抛出异常IndexError,该码块同级别的后续代码不会运行
  print('222222222222222')
  xxx
  print('3333333333333333333')
  dic = {'a':1}
  dic['a']
  print('end')
finally:
    ## 应该把被检测代码中,回收系统化资源的代码放这里
  print('我不处理异常,无论是否发生异常我都会运行')
6,打码平台使用
import base64
import json
import requests
def base64_api(uname, pwd, img, typeid):
    with open(img, 'rb') as f:
        base64_data = base64.b64encode(f.read())
        b64 = base64_data.decode()
    data = {"username": uname, "password": pwd, "typeid": typeid, "image": b64}
    result = json.loads(requests.post("http://api.ttshitu.com/predict", json=data).text)
    if result['success']:
        return result["data"]["result"]
    else:
        #!!!!!!!注意:返回 人工不足等 错误情况 请加逻辑处理防止脚本卡死 继续重新 识别
        return result["message"]
    return ''


if __name__ == "__main__":
    img_path = "./code.png"
    result = base64_api(uname='xxxxx', pwd='xxxxx', img=img_path, typeid=3)
    print(result)

import base64
import json
import requests
# 一、图片文字类型(默认 3 数英混合):
# 1 : 纯数字
# 1001:纯数字2
# 2 : 纯英文
# 1002:纯英文2
# 3 : 数英混合
# 1003:数英混合2
#  4 : 闪动GIF
# 7 : 无感学习(独家)
# 11 : 计算题
# 1005:  快速计算题
# 16 : 汉字
# 32 : 通用文字识别(证件、单据)
# 66:  问答题
# 49 :recaptcha图片识别
# 二、图片旋转角度类型:
# 29 :  旋转类型
#
# 三、图片坐标点选类型:
# 19 :  1个坐标
# 20 :  3个坐标
# 21 :  3 ~ 5个坐标
# 22 :  5 ~ 8个坐标
# 27 :  1 ~ 4个坐标
# 48 : 轨迹类型
#
# 四、缺口识别
# 18 : 缺口识别(需要2张图 一张目标图一张缺口图)
# 33 : 单缺口识别(返回X轴坐标 只需要1张图)
# 五、拼图识别
# 53:拼图识别
def base64_api(uname, pwd, img, typeid):
    with open(img, 'rb') as f:
        base64_data = base64.b64encode(f.read())
        b64 = base64_data.decode()
    data = {"username": uname, "password": pwd, "typeid": typeid, "image": b64}
    result = json.loads(requests.post("http://api.ttshitu.com/predict", json=data).text)
    if result['success']:
        return result["data"]["result"]
    else:
        #!!!!!!!注意:返回 人工不足等 错误情况 请加逻辑处理防止脚本卡死 继续重新 识别
        return result["message"]
    return ""


if __name__ == "__main__":
    img_path = "C:/Users/Administrator/Desktop/file.jpg"
    result = base64_api(uname='你的账号', pwd='你的密码', img=img_path, typeid=3)
    print(result)
7,时间模块
7.1 time 模块
import time

# 时间戳 : 从1970年到现在经过的秒数
time.time()     # 时间戳---------用于计算

# 按照某种格式显示时间: 2020-03-30 11:11:11 AM || PM
time.strftime('%Y-%m-%d %H:%M:%S %p')  # 2023-06-27 14:24:38 PM
time.strftime('%Y-%m-%d %X')    # 2023-06-27 14:24:38


#结构化时间
res = time.localtime()  ## --------------获取年月日
print(res)   ## time.struct_time(tm_year=2023, tm_mon=6, tm_mday=27, tm_hour=14, tm_min=26, tm_sec=17, tm_wday=1, 				tm_yday=178, tm_isdst=0)

print(res.tm_year)  ## 年
print(res.tm_mon)   ## 月
print(res.tm_mday)  ## 日
print(res.tm_hour)  ## 小时
print(res.tm_min)   ## 分钟
print(res.tm_sec)   ## 秒
print(res.tm_wday)
print(res.tm_yday)
print(res.tm_isdst)
7.2 datetime 模块
import datetime

datetime.datetime.now() ##  2023-06-27 14:38:31.929938

datetime.datetime.now() + datetime.timedelta(days = 3)  ## 三天后的时间  2023-06-30 14:40:55.794329
# 参数有  days || secondes || weeks || hours || minutes
# days = 3 || -3   参数可以 为负数
7.3 时间格式的转换
import time


1,时间戳 <-----------------> 结构化时间
    # 结构化时间 -------------------------> 时间戳
        s_time = time.localtime()  # 结构化时间
        res = time.mktime(s_time)
        print(res)   # 1687848357.0

    # 时间戳 ---------------------------------> 结构化时间
        tp_time = time.time()
        res = time.localtime(tp_time)
        print(res) # time.struct_time(tm_year=2023, tm_mon=6, tm_mday=27, tm_hour=14, tm_min=48, tm_sec=36, 						tm_wday=1,tm_yday=178, tm_isdst=0)
    # 时间戳 --------------------------------> 世界标准时间 --------- 跟本地时间差8小时
        tp_time = time.time()
        res = time.gmtime(tp_time)
        print(res)  # time.struct_time(tm_year=2023, tm_mon=6, tm_mday=27, tm_hour=6, tm_min=50, tm_sec=35, 						tm_wday=1,tm_yday=178, tm_isdst=0)

 2, 结构化 <-------------------------> 格式化时间
  ## time.strptime('%Y-%m-%d %H:%M:%S %p',time.localtime())
  res =  time.strptime('1988-03-03 11:11:11','%Y-%m-%d %H:%M:%S')
    print(res)
    ## time.struct_time(tm_year=1988, tm_mon=3, tm_mday=3, tm_hour=11, tm_min=11, tm_sec=11, tm_wday=3, tm_yday=63, 		tm_isdst=-1)

    '1988-03-03 11:11:11' + 7  -----------------------> 结构化时间
    s_time = time.strptime('1988-03-03 11:11:11','%Y-%m-%d %H:%M:%S') # 结构化时间
  miao = time.mktime(s_time) + 7 * 86400  ## 得到时间戳

    struct_time = time.localtime(miao) ##  得到结构化时间
    res = time.strftime('%Y-%m-%d %X',time.localtime(miao)) # 格式化时间
    print(res)   # 1988-03-10 11:11:11
7.4 ,了解
import time
## linix 操作系统上常见
print(time.asctime())  # Tue Jun 27 15:26:23 2023
8, sys 模块
1 sys.argv           # 命令行参数List,第一个元素是程序本身路径,用于获取终端里的参数
2 sys.exit(n)        # 退出程序,正常退出时exit(0)
3 sys.version        # 获取Python解释程序的版本信息
4 sys.maxint         # 最大的Int值
5 sys.path           # 返回模块的搜索路径,初始化时使用PYTHONPATH环境变量的值
6 sys.platform       # 返回操作系统平台名称
8.1 打印进度条
import time

def process():
  recv_size = 0
  total_size = 333333

  while recv_size < total_size:
    # 下载了1024个字节数据
    time.sleep(0.05)
    recv_size += 1024
        if recv_size > total_size:
      recv_size = total_size
    percent = recv_size / total_size
    res = int(50 * percent) * "#"
    # 打印进度条
    print('\r[%-50s] %d%%' % (res,100 * percent) ,end='')


process()

## [##################################################] 100%
9,shutii 模块
import shutill

# 将文件内容拷贝到另一个文件中
shutil.copyfileobj(open('old.xml','r'), open('new.xml', 'w'))

# 仅拷贝权限。内容、组、用户均不变
shutil.copymode('f1.log', 'f2.log')   #目标文件必须存在

# 拷贝文件
shutil.copyfile('f1.log', 'f2.log') #目标文件无需存在

# 仅拷贝状态的信息,包括:mode bits, atime, mtime, flags
shutil.copystat('f1.log', 'f2.log') #目标文件必须存在

# 拷贝文件和权限
shutil.copy('f1.log', 'f2.log')

# 拷贝文件和状态信息
shutil.copy2('f1.log', 'f2.log')

# 递归的去拷贝文件夹

shutil.copytree('folder1', 'folder2', ignore=shutil.ignore_patterns('*.pyc', 'tmp*'))
# 目标目录不能存在,注意对folder2目录父级目录要有可写权限,ignore的意思是排除

shutil.copytree('f1', 'f2', symlinks=True, ignore=shutil.ignore_patterns('*.pyc', 'tmp*'))
'''
通常的拷贝都把软连接拷贝成硬链接,即对待软连接来说,创建新的文件
'''

#递归的去删除文件
shutil.rmtree('folder1')

#递归的去移动文件,它类似mv命令,其实就是重命名。
shutil.move('folder1', 'folder3')

# 创建压缩包并返回文件路径,例如:zip、tar
# 创建压缩包并返回文件路径,例如:zip、tar

base_name: 压缩包的文件名,也可以是压缩包的路径。只是文件名时,则保存至当前目录,否则保存至指定路径,
    # 如 data_bak  =>保存至当前路径
    # 如:/tmp/data_bak =>保存至/tmp/
format: 压缩包种类,“zip”, “tar”, “bztar”,“gztar”
root_dir: 要压缩的文件夹路径(默认当前目录)
owner: 用户,默认当前用户
group: 组,默认当前组
logger: 用于记录日志,通常是logging.Logger对象


#将 /data 下的文件打包放置当前程序目录
ret = shutil.make_archive("data_bak", 'gztar', root_dir='/data')

#将 /data下的文件打包放置 /tmp/目录
ret = shutil.make_archive("/tmp/data_bak", 'gztar', root_dir='/data')


#shutil 对压缩包的处理是调用 ZipFile 和 TarFile 两个模块来进行的,详细:
import zipfile
    # 压缩
        z = zipfile.ZipFile('laxi.zip', 'w')
        z.write('a.log')
        z.write('data.data')
        z.close()

    # 解压
        z = zipfile.ZipFile('laxi.zip', 'r')
        z.extractall(path='.')
        z.close()


import tarfile
   # 压缩
       t=tarfile.open('/tmp/egon.tar','w')
       t.add('/test1/a.py',arcname='a.bak')
       t.add('/test1/b.py',arcname='b.bak')
       t.close()


    # 解压
        t=tarfile.open('/tmp/egon.tar','r')
        t.extractall('/egon')
        t.close()
10,pickle 模块(有兼容性问题,了解就行)
import pickle

res = pickle.dumps({1,2,3,4,5})
print(res)
# b'\x80\x04\x95\x0f\x00\x00\x00\x00\x00\x00\x00\x8f\x94(K\x01K\x02K\x03K\x04K\x05\x90.'

res = pickle.loads(res)
print(res)
# {1, 2, 3, 4, 5}

# coding:utf-8
import pickle

with open('a.pkl',mode='wb') as f:
    # 一:在python3中执行的序列化操作如何兼容python2
    # python2不支持protocol>2,默认python3中protocol=4
    # 所以在python3中dump操作应该指定protocol=2
    pickle.dump('你好啊',f,protocol=2)

with open('a.pkl', mode='rb') as f:
    # 二:python2中反序列化才能正常使用
    res=pickle.load(f)
    print(res)
11,xml 模块
<?xml version="1.0"?>
<data>
    <country name="Liechtenstein">
        <rank updated="yes">2</rank>
        <year>2008</year>
        <gdppc>141100</gdppc>
        <neighbor name="Austria" direction="E"/>
        <neighbor name="Switzerland" direction="W"/>
    </country>
    <country name="Singapore">
        <rank updated="yes">5</rank>
        <year>2011</year>
        <gdppc>59900</gdppc>
        <neighbor name="Malaysia" direction="N"/>
    </country>
    <country name="Panama">
        <rank updated="yes">69</rank>
        <year>2011</year>
        <gdppc>13600</gdppc>
        <neighbor name="Costa Rica" direction="W"/>
        <neighbor name="Colombia" direction="E"/>
    </country>
</data>


xml协议在各个语言里的都 是支持的,在python中可以用以下模块操作xml:
# print(root.iter('year')) #全文搜索
# print(root.find('country')) #在root的子节点找,只找一个
# print(root.findall('country')) #在root的子节点找,找所有

import xml.etree.ElementTree as ET

tree = ET.parse("xmltest.xml")
root = tree.getroot()
print(root.tag)

#遍历xml文档
    for child in root:
        print('========>',child.tag,child.attrib,child.attrib['name'])
        for i in child:
            print(i.tag,i.attrib,i.text)

    #只遍历year 节点
    for node in root.iter('year'):
        print(node.tag,node.text)
#---------------------------------------

import xml.etree.ElementTree as ET

tree = ET.parse("xmltest.xml")
root = tree.getroot()

#修改
    for node in root.iter('year'):
        new_year=int(node.text)+1
        node.text=str(new_year)
        node.set('updated','yes')
        node.set('version','1.0')
    tree.write('test.xml')


#删除node
    for country in root.findall('country'):
       rank = int(country.find('rank').text)
       if rank > 50:
         root.remove(country)

    tree.write('output.xml')

#在country内添加(append)节点year2
    import xml.etree.ElementTree as ET
    tree = ET.parse("a.xml")
    root=tree.getroot()
    for country in root.findall('country'):
        for year in country.findall('year'):
            if int(year.text) > 2000:
                year2=ET.Element('year2')
                year2.text='新年'
                year2.attrib={'update':'yes'}
                country.append(year2) #往country节点下添加子节点

    tree.write('a.xml.swap')


自己创建xml文档:
    import xml.etree.ElementTree as ET

    new_xml = ET.Element("namelist")
    name = ET.SubElement(new_xml,"name",attrib={"enrolled":"yes"})
    age = ET.SubElement(name,"age",attrib={"checked":"no"})
    sex = ET.SubElement(name,"sex")
    sex.text = '33'
    name2 = ET.SubElement(new_xml,"name",attrib={"enrolled":"no"})
    age = ET.SubElement(name2,"age")
    age.text = '19'

    et = ET.ElementTree(new_xml) #生成文档对象
    et.write("test.xml", encoding="utf-8",xml_declaration=True)

    ET.dump(new_xml) #打印生成的格式
12,configparser 模块(导入某种格式的配置文件)
## 配置文件内容

[section1]
k1 = v1
k2:v2
user=egon
age=18
is_admin=true
salary=31

[section2]
k1 = v1
12.1 读取
import configparser

config=configparser.ConfigParser()
config.read('a.cfg') # 读取配置文件

#查看所有的标题
res=config.sections() #['section1', 'section2']
print(res)

#查看标题section1下所有key=value的key
options=config.options('section1')
print(options) #['k1', 'k2', 'user', 'age', 'is_admin', 'salary']

#查看标题section1下所有key=value的(key,value)格式
item_list=config.items('section1')
print(item_list)
#[('k1', 'v1'), ('k2', 'v2'), ('user', 'egon'), ('age', '18'), ('is_admin', 'true'), ('salary', '31')]

#查看标题section1下user的值=>字符串格式
val=config.get('section1','user')
print(val) #egon

#查看标题section1下age的值=>整数格式
val1=config.getint('section1','age')
print(val1) #18

#查看标题section1下is_admin的值=>布尔值格式
val2=config.getboolean('section1','is_admin')
print(val2) #True

#查看标题section1下salary的值=>浮点型格式
val3=config.getfloat('section1','salary')
print(val3) #31.0
12.2 改写
import configparser

config=configparser.ConfigParser()
config.read('a.cfg',encoding='utf-8')


#删除整个标题section2
config.remove_section('section2')

#删除标题section1下的某个k1和k2
config.remove_option('section1','k1')
config.remove_option('section1','k2')

#判断是否存在某个标题
print(config.has_section('section1'))

#判断标题section1下是否有user
print(config.has_option('section1',''))


#添加一个标题
config.add_section('egon')

#在标题egon下添加name=egon,age=18的配置
config.set('egon','name','egon')
config.set('egon','age',18) #报错,必须是字符串


#最后将修改的内容写入文件,完成最终的修改
config.write(open('a.cfg','w'))
13 hashlib 模块
# hash是一类算法,该算法根据传入的内容,经过运算得到一串哈希值

# hash值的特单
  1,传入的内容一样,则得到的结果一样
    2,无论传多大内容,得到的hash值长度一样
    3,不能反向破解
14 subprocess 模块
import subprocess
 '''
 sh-3.2# ls /Users/egon/Desktop |grep txt$
 mysql.txt
 tt.txt
 事物.txt
 '''
## 查看 /Users/jieli/Desktop 下的文件列表
res1=subprocess.Popen('ls /Users/jieli/Desktop',shell=True,stdout=subprocess.PIPE,stderr=subprocess.PIPE)
# shell = True 意思是调一个终端  stdout 是正确结果的输出管道   stderr 是接受错误结果的输出管道
# res1 是对象
print(res2.stdout.read()) # 打印正确的结果,得到的格式是字节,解码用的是系统的编码格式,mac为utf-8
print(res1.stderr.read()) # 打印错误的结果,得到的是字节格式,解码用的是系统的编码格式,windows为gbk

res=subprocess.Popen('grep txt$',shell=True,stdin=res1.stdout,stdout=subprocess.PIPE)
print(res.stdout.read().decode('utf-8'))


#等同于上面,但是上面的优势在于,一个数据流可以和另外一个数据流交互,可以通过爬虫得到结果然后交给grep
res1=subprocess.Popen('ls /Users/jieli/Desktop |grep txt$',shell=True,stdout=subprocess.PIPE)
print(res1.stdout.read().decode('utf-8'))

#windows下:
# dir | findstr 'test*'
# dir | findstr 'txt$'

import subprocess
res1=subprocess.Popen(r'dir C:\Users\Administrator\PycharmProjects\test\函数备课',shell=True,stdout=subprocess.PIPE)
res=subprocess.Popen('findstr test*',shell=True,stdin=res1.stdout,
                 stdout=subprocess.PIPE)

print(res.stdout.read().decode('gbk')) #subprocess使用当前系统默认编码,得到结果为bytes类型,在windows下需要用gbk解码
15,日志模块(logging)
14.1 日志级别
import logging

CRITICAL = 50 #FATAL = CRITICAL
ERROR = 40
WARNING = 30 #WARN = WARNING
INFO = 20
DEBUG = 10
NOTSET = 0 #不设置
14.2 默认级别为 warning,默认打印到终端
import logging

logging.debug('调试debug')
logging.info('消息info')
logging.warning('警告warn')  ## WARNING:root:警告warn
logging.error('错误error')  ## ERROR:root:错误error
logging.critical('严重critical')  ## CRITICAL:root:严重critical

'''
WARNING:root:警告warn
ERROR:root:错误error
CRITICAL:root:严重critical
'''
14.3 为 logging 模块指定全局配置,针对所有 logger 有效,控制打印到文件中
'''
可在logging.basicConfig()函数中可通过具体参数来更改logging模块默认行为,可用参数有

    filename:用指定的文件名创建FiledHandler(后边会具体讲解handler的概念),这样日志会被存储在指定的文件中。
    filemode:文件打开方式,在指定了filename时使用这个参数,默认值为“a”还可指定为“w”。
    format:指定handler使用的日志显示格式。
    datefmt:指定日期时间格式。
    level:设置rootlogger(后边会讲解具体概念)的日志级别
    stream:用指定的stream创建StreamHandler。可以指定输出到sys.stderr,sys.stdout或者文件,默认为sys.stderr。若同时列出了			filename和stream两个参数,则stream参数会被忽略。
'''
## 例如:
logging.basicConfig(
  format = '%(asctime)s -  %(name)s - %(levelname)s - %(module)s' # 就这样自定义格式
)
format参数中可能用到的格式化串:
%(name)s # Logger的名字
%(levelno)s # 数字形式的日志级别
%(levelname)s # 文本形式的日志级别
%(pathname)s # 调用日志输出函数的模块的完整路径名,可能没有
%(filename)s # 调用日志输出函数的模块的文件名
%(module)s # 调用日志输出函数的模块名
%(funcName)s # 调用日志输出函数的函数名
%(lineno)d # 调用日志输出函数的语句所在的代码行
%(created)f # 当前时间,用UNIX标准的表示时间的浮 点数表示
%(relativeCreated)d # 输出日志信息时的,自Logger创建以 来的毫秒数
%(asctime)s # 字符串形式的当前时间。默认格式是 “2003-07-08 16:49:45,896”。逗号后面的是毫秒
%(thread)d # 线程ID。可能没有
%(threadName)s # 线程名。可能没有
%(process)d # 进程ID。可能没有
%(message)s # 用户输出的消息
14.4 使用例子
#========使用

import logging
logging.basicConfig(
    ## 写到文件里的编码格式以系统编码格式为准,Windows为gbk
    filename='access.log',  ## 日志输出的位置
    format='%(asctime)s - %(name)s - %(levelname)s -%(module)s:  %(message)s', ## 一个日志输出的格式
    datefmt='%Y-%m-%d %H:%M:%S %p', ## 输出里的时间格式
    level=10  ## 日志错误级别
)

logging.debug('调试debug')
logging.info('消息info')
logging.warning('警告warn')
logging.error('错误error')
logging.critical('严重critical')

#========结果
access.log内容:
2017-07-28 20:32:17 PM - root - DEBUG -test:  调试debug
2017-07-28 20:32:17 PM - root - INFO -test:  消息info
2017-07-28 20:32:17 PM - root - WARNING -test:  警告warn
2017-07-28 20:32:17 PM - root - ERROR -test:  错误error
2017-07-28 20:32:17 PM - root - CRITICAL -test:  严重critical
14.5 logging 模块的 Formatter,Handler,Logger,Filter 对象
#logger:产生日志的对象
#Filter:过滤日志的对象
#Handler:接收日志然后控制打印到不同的地方,FileHandler用来打印到文件中,StreamHandler用来打印到终端
#Formatter对象:可以定制不同的日志格式对象,然后绑定给不同的Handler对象使用,以此来控制不同的Handler的日志格式

'''
critical=50
error =40
warning =30
info = 20
debug =10
'''


import logging

#1、logger对象:负责产生日志,然后交给Filter过滤,然后交给不同的Handler输出
logger=logging.getLogger(__file__)

#2、Filter对象:不常用,略

#3、Handler对象:接收logger传来的日志,然后控制输出
h1=logging.FileHandler('t1.log') #打印到文件
h2=logging.FileHandler('t2.log') #打印到文件
h3=logging.StreamHandler() #打印到终端

#4、Formatter对象:日志格式
formmater1=logging.Formatter(
    '%(asctime)s - %(name)s - %(levelname)s -%(module)s:  %(message)s',
    datefmt='%Y-%m-%d %H:%M:%S %p',
)

formmater2=logging.Formatter(
    '%(asctime)s :  %(message)s',
    datefmt='%Y-%m-%d %H:%M:%S %p',
)

formmater3=logging.Formatter('%(name)s %(message)s',)


#5、为Handler对象绑定格式
h1.setFormatter(formmater1)
h2.setFormatter(formmater2)
h3.setFormatter(formmater3)

#6、将Handler添加给logger并设置日志级别
logger.addHandler(h1)
logger.addHandler(h2)
logger.addHandler(h3)
logger.setLevel(10)

#7、测试
logger.debug('debug')
logger.info('info')
logger.warning('warning')
logger.error('error')
logger.critical('critical')
14.6 Logger 与 Handler 的级别
### logger是第一级过滤,然后才能到handler,我们可以给logger和handler同时设置level


#验证
import logging

form=logging.Formatter(
    '%(asctime)s - %(name)s - %(levelname)s -%(module)s:  %(message)s',
    datefmt='%Y-%m-%d %H:%M:%S %p',
)

ch=logging.StreamHandler()

ch.setFormatter(form)
# ch.setLevel(10)
ch.setLevel(20)

l1=logging.getLogger('root')
# l1.setLevel(20)
l1.setLevel(10)
l1.addHandler(ch)

l1.debug('l1 debug')
14.7 Logger 的继承(了解)
import logging

formatter=logging.Formatter('%(asctime)s - %(name)s - %(levelname)s -%(module)s:  %(message)s',
                    datefmt='%Y-%m-%d %H:%M:%S %p',)

ch=logging.StreamHandler()
ch.setFormatter(formatter)


logger1=logging.getLogger('root')
logger2=logging.getLogger('root.child1')
logger3=logging.getLogger('root.child1.child2')


logger1.addHandler(ch)
logger2.addHandler(ch)
logger3.addHandler(ch)
logger1.setLevel(10)
logger2.setLevel(10)
logger3.setLevel(10)

logger1.debug('log1 debug')
logger2.debug('log2 debug')
logger3.debug('log3 debug')
'''
2017-07-28 22:22:05 PM - root - DEBUG -test:  log1 debug
2017-07-28 22:22:05 PM - root.child1 - DEBUG -test:  log2 debug
2017-07-28 22:22:05 PM - root.child1 - DEBUG -test:  log2 debug
2017-07-28 22:22:05 PM - root.child1.child2 - DEBUG -test:  log3 debug
2017-07-28 22:22:05 PM - root.child1.child2 - DEBUG -test:  log3 debug
2017-07-28 22:22:05 PM - root.child1.child2 - DEBUG -test:  log3 debug
'''
14.8 应用
14.8.1 logging 配置
"""
logging配置
"""

import os
import logging.config

# 定义三种日志输出格式 开始

standard_format = '[%(asctime)s][%(threadName)s:%(thread)d][task_id:%(name)s][%(filename)s:%(lineno)d]' \
                  '[%(levelname)s][%(message)s]' #其中name为getlogger指定的名字

simple_format = '[%(levelname)s][%(asctime)s][%(filename)s:%(lineno)d]%(message)s'

id_simple_format = '[%(levelname)s][%(asctime)s] %(message)s'

# 定义日志输出格式 结束

logfile_dir = os.path.dirname(os.path.abspath(__file__))  # log文件的目录

logfile_name = 'all2.log'  # log文件名

# 如果不存在定义的日志目录就创建一个
if not os.path.isdir(logfile_dir):
    os.mkdir(logfile_dir)

# log文件的全路径
logfile_path = os.path.join(logfile_dir, logfile_name)

# log配置字典
LOGGING_DIC = {
    'version': 1,
    'disable_existing_loggers': False,
    'formatters': {
        'standard': {
            'format': standard_format
        },
        'simple': {
            'format': simple_format
        },
    },
    'filters': {},
    'handlers': {
        #打印到终端的日志
        'console': {
            'level': 'DEBUG',
            'class': 'logging.StreamHandler',  # 打印到屏幕
            'formatter': 'simple'
        },
        #打印到文件的日志,收集info及以上的日志
        'default': {
            'level': 'DEBUG',
            'class': 'logging.handlers.RotatingFileHandler',  # 保存到文件
            'formatter': 'standard',
            'filename': logfile_path,  # 日志文件
            'maxBytes': 1024*1024*5,  # 日志大小 5M
            'backupCount': 5,
            'encoding': 'utf-8',  # 日志文件的编码,再也不用担心中文log乱码了
        },
    },
    'loggers': {
        #logging.getLogger(__name__)拿到的logger配置
        '': {
            'handlers': ['default', 'console'],  # 这里把上面定义的两个handler都加上,即log数据既写入文件又打印到屏幕
            'level': 'DEBUG',
            'propagate': True,  # 向上(更高level的logger)传递
        },
    },
}


def load_my_logging_cfg():
    logging.config.dictConfig(LOGGING_DIC)  # 导入上面定义的logging配置
    logger = logging.getLogger(__name__)  # 生成一个log实例
    logger.info('It works!')  # 记录该文件的运行状态

if __name__ == '__main__':
    load_my_logging_cfg()
14.8.2 使用
"""
MyLogging Test
"""

import time
import logging
import my_logging  # 导入自定义的logging配置

logger = logging.getLogger(__name__)  # 生成logger实例


def demo():
    logger.debug("start range... time:{}".format(time.time()))
    logger.info("中文测试开始。。。")
    for i in range(10):
        logger.debug("i:{}".format(i))
        time.sleep(0.2)
    else:
        logger.debug("over range... time:{}".format(time.time()))
    logger.info("中文测试结束。。。")

if __name__ == "__main__":
    my_logging.load_my_logging_cfg()  # 在你程序文件的入口加载自定义logging配置
    demo()
14.8.3 注意注意注意
"""
MyLogging Test
"""

import time
import logging
import my_logging  # 导入自定义的logging配置

logger = logging.getLogger(__name__)  # 生成logger实例


def demo():
    logger.debug("start range... time:{}".format(time.time()))
    logger.info("中文测试开始。。。")
    for i in range(10):
        logger.debug("i:{}".format(i))
        time.sleep(0.2)
    else:
        logger.debug("over range... time:{}".format(time.time()))
    logger.info("中文测试结束。。。")

if __name__ == "__main__":
    my_logging.load_my_logging_cfg()  # 在你程序文件的入口加载自定义logging配置
    demo()
14.8.4 另外一个 django 的配置,瞄一眼就可以,跟上面的一样
#logging_config.py
LOGGING = {
    'version': 1,
    'disable_existing_loggers': False,
    'formatters': {
        'standard': {
            'format': '[%(asctime)s][%(threadName)s:%(thread)d][task_id:%(name)s][%(filename)s:%(lineno)d]'
                      '[%(levelname)s][%(message)s]'
        },
        'simple': {
            'format': '[%(levelname)s][%(asctime)s][%(filename)s:%(lineno)d]%(message)s'
        },
        'collect': {
            'format': '%(message)s'
        }
    },
    'filters': {
        'require_debug_true': {
            '()': 'django.utils.log.RequireDebugTrue',
        },
    },
    'handlers': {
        #打印到终端的日志
        'console': {
            'level': 'DEBUG',
            'filters': ['require_debug_true'],
            'class': 'logging.StreamHandler',
            'formatter': 'simple'
        },
        #打印到文件的日志,收集info及以上的日志
        'default': {
            'level': 'INFO',
            'class': 'logging.handlers.RotatingFileHandler',  # 保存到文件,自动切
            'filename': os.path.join(BASE_LOG_DIR, "xxx_info.log"),  # 日志文件
            'maxBytes': 1024 * 1024 * 5,  # 日志大小 5M
            'backupCount': 3,
            'formatter': 'standard',
            'encoding': 'utf-8',
        },
        #打印到文件的日志:收集错误及以上的日志
        'error': {
            'level': 'ERROR',
            'class': 'logging.handlers.RotatingFileHandler',  # 保存到文件,自动切
            'filename': os.path.join(BASE_LOG_DIR, "xxx_err.log"),  # 日志文件
            'maxBytes': 1024 * 1024 * 5,  # 日志大小 5M
            'backupCount': 5,
            'formatter': 'standard',
            'encoding': 'utf-8',
        },
        #打印到文件的日志
        'collect': {
            'level': 'INFO',
            'class': 'logging.handlers.RotatingFileHandler',  # 保存到文件,自动切
            'filename': os.path.join(BASE_LOG_DIR, "xxx_collect.log"),
            'maxBytes': 1024 * 1024 * 5,  # 日志大小 5M
            'backupCount': 5,
            'formatter': 'collect',
            'encoding': "utf-8"
        }
    },
    'loggers': {
        #logging.getLogger(__name__)拿到的logger配置
        '': {
            'handlers': ['default', 'console', 'error'],
            'level': 'DEBUG',
            'propagate': True,
        },
        #logging.getLogger('collect')拿到的logger配置
        'collect': {
            'handlers': ['console', 'collect'],
            'level': 'INFO',
        }
    },
}


# -----------
# 用法:拿到俩个logger

logger = logging.getLogger(__name__) #线上正常的日志
collect_logger = logging.getLogger("collect") #领导说,需要为领导们单独定制领导们看的日志
14.9 直奔主题,常规使用
14.9.1 日志级别与配置
import logging
# 在
# 一:日志配置
logging.basicConfig(
    # 1、日志输出位置:1、终端 2、文件
    # filename='access.log', # 不指定,默认打印到终端

    # 2、日志格式
    format='%(asctime)s - %(name)s - %(levelname)s -%(module)s:  %(message)s',

    # 3、时间格式
    datefmt='%Y-%m-%d %H:%M:%S %p',

    # 4、日志级别
    # critical => 50
    # error => 40
    # warning => 30
    # info => 20
    # debug => 10
    level=30,
)

# 二:输出日志
logging.debug('调试debug')
logging.info('消息info')
logging.warning('警告warn')
logging.error('错误error')
logging.critical('严重critical')

'''
# 注意下面的root是默认的日志名字
WARNING:root:警告warn
ERROR:root:错误error
CRITICAL:root:严重critical
'''
14.9.2 日志配置字典(setting.py)
"""
logging配置
在 setting.py中定义
"""

import os

# 1、定义三种日志输出格式,日志中可能用到的格式化串如下
# %(name)s Logger的名字
# %(levelno)s 数字形式的日志级别
# %(levelname)s 文本形式的日志级别
# %(pathname)s 调用日志输出函数的模块的完整路径名,可能没有
# %(filename)s 调用日志输出函数的模块的文件名
# %(module)s 调用日志输出函数的模块名
# %(funcName)s 调用日志输出函数的函数名
# %(lineno)d 调用日志输出函数的语句所在的代码行
# %(created)f 当前时间,用UNIX标准的表示时间的浮 点数表示
# %(relativeCreated)d 输出日志信息时的,自Logger创建以 来的毫秒数
# %(asctime)s 字符串形式的当前时间。默认格式是 “2003-07-08 16:49:45,896”。逗号后面的是毫秒
# %(thread)d 线程ID。可能没有
# %(threadName)s 线程名。可能没有
# %(process)d 进程ID。可能没有
# %(message)s用户输出的消息

# 2、强调:其中的%(name)s为getlogger时指定的名字
## 这些是预先定义好的自定义格式
standard_format = '[%(asctime)s][%(threadName)s:%(thread)d][task_id:%(name)s][%(filename)s:%(lineno)d]' \
                  '[%(levelname)s][%(message)s]'

simple_format = '[%(levelname)s][%(asctime)s][%(filename)s:%(lineno)d]%(message)s'

test_format = '%(asctime)s] %(message)s'

# 3、日志配置字典
LOGGING_DIC = {
    'version': 1,
    'disable_existing_loggers': False,

    'formatters': {
        # 自己自定义的日志格式,可以自己改
        'standard': {
            # 自己定义的自定义格式
            'format': standard_format
        },
        'simple': {
            'format': simple_format
        },
        'test': {
            'format': test_format
        },
    },

    'filters': {},

    ## 日志的接受者,不同的handle可以使日志输出到不同位置
    'handlers': {
        #打印到终端的日志
        'console': {
            'level': 'DEBUG',
            'class': 'logging.StreamHandler',  # 打印到屏幕
            ## 指定输出格式
            'formatter': 'simple'
        },

        #打印到文件的日志,收集info及以上的日志
        'default': {
            'level': 'DEBUG',
            'class': 'logging.handlers.RotatingFileHandler',  # 保存到文件,日志轮转
            'formatter': 'standard',
            # 可以定制日志文件路径
            # BASE_DIR = os.path.dirname(os.path.abspath(__file__))  # log文件的目录
            # LOG_PATH = os.path.join(BASE_DIR,'a1.log')
            'filename': 'a1.log',  # 日志文件
            'maxBytes': 1024*1024*5,  # 日志大小 5M
            'backupCount': 5,
            'encoding': 'utf-8',  # 日志文件的编码,再也不用担心中文log乱码了
        },

        ## 测试用的日志格式
        'other': {
            'level': 'DEBUG',
            'class': 'logging.FileHandler',  # 保存到文件
            'formatter': 'test',
            'filename': 'a2.log',##拿到项目的跟文件夹 os.path.dirname(os.path.dirname(__file__))
            'encoding': 'utf-8',
        },
    },

    # 负责产生日志,产生的日志传递给handler负责处理
    'loggers': {
        #logging.getLogger(__name__)拿到的logger配置
        'kkk': {
            #  kkk 产生的日志传给谁
            'handlers': ['default', 'console'],  # 这里把上面定义的两个handler都加上,即log数据既写入文件又打印到屏幕
            'level': 'DEBUG', # loggers(第一层日志级别关限制)--->handlers(第二层日志级别关卡限制)
            'propagate': False,  # 默认为True,向上(更高level的logger)传递,通常设置为False即可,否则会一份日志向上层层#  传递
        },

        'bbb': {
            #  kkk 产生的日志传给谁
            'handlers': ['console'],  # 这里把上面定义的两个handler都加上,即log数据既写入文件又打印到屏幕
            'level': 'DEBUG', # loggers(第一层日志级别关限制)--->handlers(第二层日志级别关卡限制)
            'propagate': False,  # 默认为True,向上(更高level的logger)传递,通常设置为False即可,否则会一份日志向上层层#  传递
        },
        '专门的采集': {
            'handlers': ['other',],
            'level': 'DEBUG',
            'propagate': False,
        },
    },
}
14.9.3 使用
import settings

# !!!强调!!!
# 1、logging是一个包,需要使用其下的config、getLogger,可以如下导入
# 可能不能正常使用
# import logging.config
# import logging.getLogger

# 2、也可以使用如下导入
# from logging import config,getLogger

from logging import config # 这样连同logging.getLogger都一起导入了,然后使用前缀logging.config.
from logging import getLogger # 用于获取配置文件里的日志生产者

# 3、加载配置
# 把配置好的配置字典扔进去
logging.config.dictConfig(settings.LOGGING_DIC)

logger1 = getLogger("kkk")  ## kkk 是可以同时向终端和文件里输出日志的
logger2 = getLogger('bbb')  ### bbb 只向终端里输出日志

# 4、输出日志
logger1=logging.getLogger('用户交易')
logger1.info('egon儿子alex转账3亿冥币')

# logger2=logging.getLogger('专门的采集') # 名字传入的必须是'专门的采集',与LOGGING_DIC中的配置唯一对应
# logger2.debug('专门采集的日志')
14.9.4 日志轮换
   ## 'class': 'logging.handlers.RotatingFileHandler',  # 保存到文件,日志轮转
   ## 'maxBytes': 1024*1024*5,  # 日志大小 5M
   ##  'backupCount': 5,  最多保运几份

    #打印到文件的日志,收集info及以上的日志
        'default': {
            'level': 'DEBUG',
            'class': 'logging.handlers.RotatingFileHandler',  # 保存到文件,日志轮转
            'formatter': 'standard',
            # 可以定制日志文件路径
            # BASE_DIR = os.path.dirname(os.path.abspath(__file__))  # log文件的目录
            # LOG_PATH = os.path.join(BASE_DIR,'a1.log')
            'filename': 'a1.log',  # 日志文件
            'maxBytes': 1024*1024*5,  # 日志大小 5M
            'backupCount': 5,
            'encoding': 'utf-8',  # 日志文件的编码,再也不用担心中文log乱码了
        },
15,struct 模块
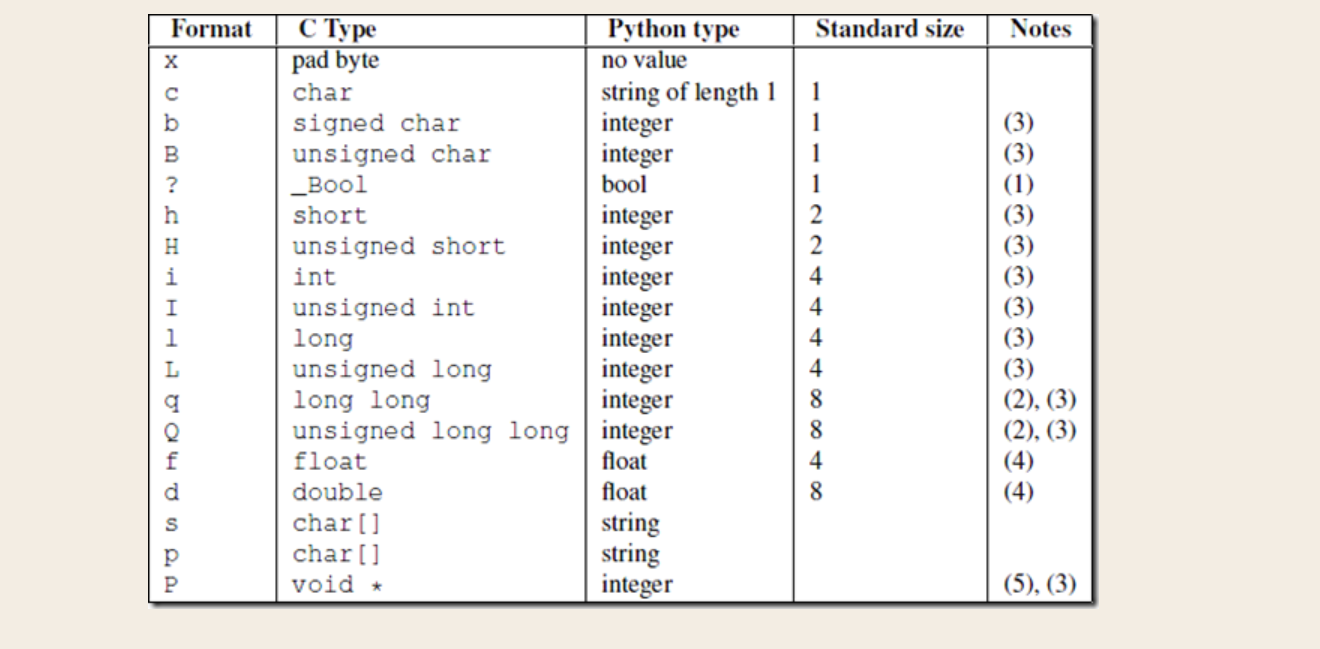
## 该模块可以把一个类型,如数字,转成固定长度的bytes
import struct
bytes = struct.pack('i',1000) ## 拿到长度固定的四个字节
num = struct.unpack('i',bytes)[0]   ## 结果是元祖,元祖里拿到数字拿到数字